03 Compute 体素化
体素空间与 3D GBuffer 定义了数据应该存在哪里;本篇处理另一半问题:如何把 Unity 场景中的 Renderer、网格和材质转换为对三维网格的并发写入。当前实现不要求材质额外提供 Voxelization Pass,而是由 Compute Shader 读取 Raw Vertex/Index Buffer,按三角形覆盖范围写入原子累积 Buffer,最后 Resolve 成浮点 3D GBuffer。
一、Renderer 输入
贯穿本篇的例子是一只代表性三角形 △T。它属于一个同时带有 MeshRenderer、材质和世界变换的对象;在 Renderer 阶段,△T 还只是 Registry 快照中的候选几何,先要和它所在 Renderer 一起通过状态、LayerMask、Bounds、SubMesh 与 Render Queue 过滤。
体素化从 Renderer Registry 的快照开始。它会排除未启用、非活动层级、forceRenderingOff、LayerMask 不匹配、Bounds 与体素立方体不相交的 Renderer;只保留包含三角形 SubMesh、处于 Opaque Render Queue 且允许贡献表面的对象。
MeshRenderer 与 SkinnedMeshRenderer 都能进入同一流程。普通 Mesh 读取静态网格缓冲区;Skinned Mesh 读取当前蒙皮后的顶点缓冲区。它们最终都转换为三角形、材质参数和对象变换,再交给同一个 VoxelizeMesh Kernel。
Registry 提供的是候选对象集合,不替代 URP 的正常渲染。体素化只额外建立场景的三维表面缓存,普通材质仍继续走 URP/Lit 的可见表面 Pass。
二、网格缓冲区
通过过滤后,△T 进入 Buffer 阶段:它不再只是 Renderer 上的几何概念,而是由三个索引指向 Raw Vertex Buffer 中的顶点记录,并由 Index Buffer 和对象变换共同描述。普通 Mesh 与 Skinned Mesh 只是在这些 Buffer 的来源上不同。
普通 Mesh 使用 Mesh.GetVertexBuffer 与 Mesh.GetIndexBuffer 取得原始缓冲区。对于 SkinnedMeshRenderer,只有位置、法线或 UV 位于 stream 0 时,才使用 SkinnedMeshRenderer.GetVertexBuffer 读取当前蒙皮结果;非 0 stream 回退到静态 Mesh.GetVertexBuffer(stream),索引仍来自 Mesh.GetIndexBuffer。这意味着“Skinned Mesh”不等于所有顶点流都会随当前姿态更新。
Compute Shader 将位置、法线、UV 和索引输入声明为 ByteAddressBuffer。它不假定所有模型共用同一顶点布局,而是由 C# 同时传入每个属性的 stream、stride、offset、format 和 dimension。Shader 根据顶点编号计算属性字节地址,再把原始 word 解码为需要的分量。
这条输入路径让 Compute 阶段直接处理几何数据,同时避免复制一套 URP/Lit 表面 Shader。体素化关心的是表面在三维网格里的离散覆盖,最终画面仍由常规渲染路径产生。
三、顶点与索引格式
进入 Format 阶段时,△T 携带的是“如何解释这三组字节”的元数据:每个顶点属性的 stream、stride、offset、format、dimension,以及它的三个逻辑索引。此时数据还没有投影到体素坐标,Compute Shader 先把原始字节还原为位置、法线和 UV。
一个顶点属性的读取地址由顶点编号、stream、stride 和属性 offset 决定:
Position、Normal 与 TexCoord0 可以位于不同 stream。若 Mesh 缺少 Normal,体素化使用三角形面法线;若缺少 UV,则以零坐标采样材质。C# 把 VertexAttributeFormat 和 dimension 编码为参数,Shader 据此读取 Float32、Float16 或归一化格式。
每个 SubMesh 提供 indexStart、indexCount 与 baseVertex。逻辑索引先映射到 Index Buffer 地址,再按 16 位或 32 位 index format 解码:
位置经过 ObjectToWorld 和 WorldToVoxel 后才进入覆盖测试。法线使用对象矩阵的逆转置变换,以保持非均匀缩放下的正确方向。
四、SubMesh Dispatch
当 C# 为这个 SubMesh 建立 Dispatch 时,△T 携带的索引范围被收敛为 indexStart、indexCount 和 baseVertex;它会进入一个 VoxelizeMesh 线程,而不是为每个顶点单独开一次 Dispatch。
每个 Triangle SubMesh 对应一次 VoxelizeMesh Dispatch。三角形数量由该 SubMesh 的 indexCount 得到:
VoxelizeMesh 的线程组大小为 ,每个线程处理一个三角形。Dispatch 组数以 CeilDiv 计算,Shader 通过 SV_DispatchThreadID 的边界判断跳过超过 triangleCount 的线程,因此三角形数量不需要恰好是 64 的倍数。
Dispatch 前会绑定 ObjectToWorld、NormalToWorld、indexStart、baseVertex、Raw Buffer 描述与材质参数。相同 Kernel 因而能够处理不同顶点布局、不同材质和不同 SubMesh。
体素化阶段使用 Render Graph 的 AddUnsafePass,原因不是它“更快”,而是执行时会遍历外部 Renderer,并直接绑定 Mesh/SkinnedMeshRenderer 的 Raw GraphicsBuffer;这些动态外部资源没有对应的 Render Graph Handle,且现有 ComputeVoxelizer 使用传统 CommandBuffer 记录 Dispatch,无法由图完整跟踪和验证。由 Render Graph 创建的纹理与原子 Buffer 仍会显式声明读写访问。
五、材质数据
△T 进入材质阶段后,又带上了当前 SubMesh 的材质引用与对象变换。这个三角形的每个候选体素将据此采样 Albedo、Emissive,并执行 Alpha Clip;材质输入跟随 △T 的覆盖位置,而不是脱离几何单独生成一份颜色。
体素化复用 URP/Lit 的常用属性。_BaseMap 与 _BaseColor 决定 Albedo;_EmissionMap 与 _EmissionColor 只在 _EMISSION 关键字开启时写入 HDR Emissive;_AlphaClip 与 _Cutoff 决定一个采样点是否在写入前被丢弃。
透明 Render Queue 整体不参与当前体素化。Alpha Clip 与透明不同:它仍是离散表面,只是在采样 BaseMap 后按 Cutoff 丢弃不足以覆盖的部分。因此树叶和栅栏等 Alpha Clip 材质能够写入体素,半透明玻璃不会被当作不透明 GI 表面。
重心坐标同时插值 UV、世界法线和第三维位置。材质采样发生在候选体素中心,而不是顶点上,因此纹理、Emission 与裁剪都与真实覆盖位置对应。
六、主轴投影
现在 △T 已经由 Buffer、Format、SubMesh 和 Material 输入还原到体素空间,下一步才把它作为一个三维三角形送入主轴选择。它携带的是三个体素空间顶点及由它们导出的面法线。
三角形位于三维体素网格中,但覆盖测试适合先在二维完成。Kernel 计算体素空间面法线:
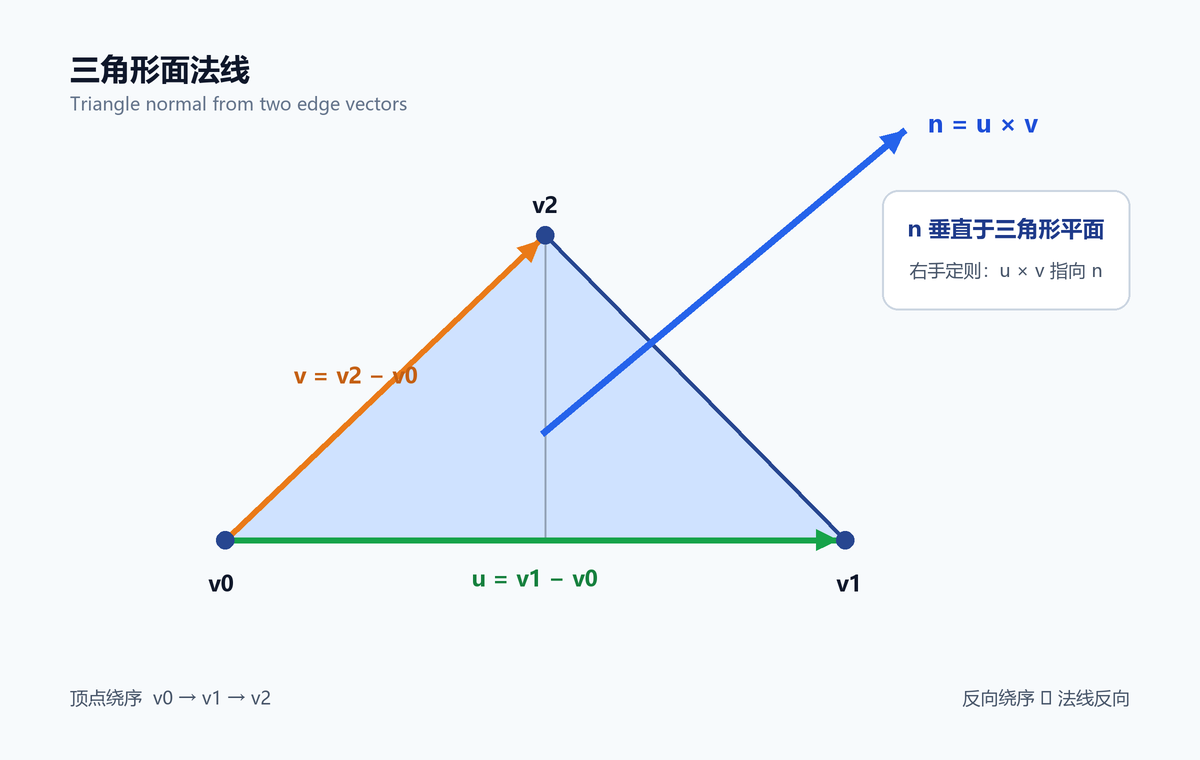
叉积的长度表示由两条边向量张成的平行四边形面积,方向则由右手定则决定;因此交换顶点绕序会同时反转法线方向,而法线分量随后用于选择主轴投影。
再选择绝对分量最大的轴:
RGB 坐标轴由用户生成的 CoordinateArrow.glb 组成,滑块可改变法线分量;Demo 会高亮最大绝对分量对应的主轴与投影平面。下方静态 SVG 继续作为固定 主轴案例。
沿该轴观察时,三角形投影面积最大,不容易退化为细线。当前 Kernel 使用严格的 > 比较:只有 且 才选 ;在相等情形下会落到 ,而 只有在 且 时选中。因此 tie-break 是确定的, 优先于相等的 。选择 时在 平面测试;选择 或 时相应使用 或 平面,未投影的第三个坐标随后由重心权重恢复。
七、覆盖测试
主轴确定后,△T 的三维形状暂时表现为某个二维投影三角形,第三维仍由重心权重保留。接下来它携带投影包围盒、边函数和插值用的重心坐标,进入候选体素覆盖测试。
投影后的三角形先计算二维包围盒,只遍历可能被覆盖的整数格点。对每个候选体素中心 ,Kernel 计算三条有向边函数:
三条边函数与三角形有向面积组合为重心坐标。若采样点位于三条边的同侧,便属于投影三角形;重心权重可插值 UV、世界法线以及未投影的第三维,再恢复三维体素坐标。
细小或倾斜三角形可能从离散格点之间穿过。启用 conservativeRasterization 时,当前 Kernel 的包围盒扩张是 bboxExpansion = max(conservativeScale, 0.5);边函数容差另为 edgeTolerance = bboxExpansion × (三条投影边长度),并以 edge < -edgeTolerance 判定排除。它不是一个脱离边长度的泛化厚度;代价是更多候选体素、更多材质采样与更高的原子竞争。
八、并发累积
当 △T 的投影覆盖某个体素时,它不直接写最终 GBuffer,而是携带该候选点的 Albedo、Normal、Emissive、Opacity 和样本数,和其他三角形一起进入同一个线性地址的原子累积位置。
不同三角形常会覆盖同一个体素,因此不能依赖线程写入顺序。三维体素坐标先被压平为线性地址:
8.1 原始 Texture Atomic 路径
原始提交 0a8a34e 采用的是“光栅化三角形,再由 Fragment Shader 原子写入三维纹理”的路径。Lit.shader 在体素化 Pass 中要求 Shader Model 5.0 和 Geometry Shader:
#pragma target 5.0
#pragma require geometry
#pragma vertex VoxelizationVs
#pragma geometry VoxelizationGs
#pragma fragment VoxelizationFs
Geometry Shader 把三角形投影到主轴平面,Fragment Shader 随后绑定四张具有固定 UAV 槽位的整数三维纹理:
RWTexture3D<uint> OutAlbedo          : register(u1);
RWTexture3D<uint> OutNormal          : register(u2);
RWTexture3D<uint> OutTmpOpacityAccum : register(u3);
RWTexture3D<uint> OutTmpEmissiveAccum: register(u4);
对应的 C# 资源是四张 RenderTextureFormat.RInt、TextureDimension.Tex3D、enableRandomWrite = true 的 RenderTexture,并通过 SetRandomWriteTarget(1...4) 同时绑定。Albedo/Normal 的移动平均依赖 InterlockedCompareExchange,Opacity/Emissive 的标量累积依赖 InterlockedMax;这些操作发生在 RWTexture3D<uint> 的具体体素上。
这里的兼容门槛不是普通的 Texture3D 采样。平台必须同时提供传统 Geometry Shader、Fragment 阶段 UAV、多 UAV 槽位、R32 整数三维 Storage Texture,以及对这种纹理的原子操作。原始 Lit.shader 的 ForwardLit Pass 还单独写有 #pragma exclude_renderers gles gles3 glcore;体素化 Pass 虽未重复该指令,但它的 target 5.0 + geometry 与三维 Texture Atomic 路径同样无法在这些后端上形成等价实现。桌面 D3D11/12 较容易满足这组能力;Metal 缺少这条传统 Geometry Shader 路径,GLES/WebGL 无法承载该组合,部分移动 Vulkan 设备也取决于具体格式、阶段和原子能力。因而这里讨论的是原始实现所需能力的交集,不是“所有非 D3D 平台都不支持 3D Texture”。
8.2 Buffer Atomic 路径
本帧使用 AlbedoAccumulation、NormalAccumulation、EmissiveAccumulation 与 OpacityAccumulation 四个原子 Buffer。Albedo 与 Normal 通过 Compare-And-Swap 循环维护量化后的增量平均;Opacity 使用 InterlockedMax 保留最大遮挡;Emissive 使用 uint4,以 1024 固定点缩放 RGB,并用第四个分量记录样本数。
Albedo 与 Normal 的 CAS 打包值用 32 位承载 8-bit RGB + 8-bit count:前三个字节存量化颜色,最低 8 位存样本数。计数未到 255 时执行增量平均;计数达到 255 后不再溢出,而是使用固定 1/255 权重做平滑更新。Opacity 仍使用 InterlockedMax,Emissive 仍是独立的 uint4 累积。
这些 Buffer 是并发写入的中间态,不是 3D GBuffer。本次 Pass 结束后,它们会被 Resolve Kernel 转换为浮点三维纹理。当前路径因此变为“Compute 读取 Raw Mesh Buffer → RWStructuredBuffer<uint/uint4> 原子累积 → Resolve 写入 RWTexture3D<float4>”,移除了 Geometry Shader、Fragment UAV 和整数三维纹理原子操作。Buffer Atomic 在现代图形 API 之间更容易映射,但这并不等于无条件支持所有平台:Compute Shader、Structured Buffer 原子操作以及浮点三维 UAV 仍然是运行前提。
九、GBuffer Resolve
完成并发累积后,△T 已经不再以“一个完整三角形”存在;它对每个覆盖体素的贡献被拆进四个原子 Buffer,并与其他三角形贡献合并。Resolve Kernel 现在按体素回收这些贡献,输出统一的浮点 3D GBuffer。
体素化由三个 Compute Kernel 串成一个阶段:
| Kernel | 线程组 | 职责 |
|---|---|---|
ClearVoxelAccumulation | 清空四个原子累积 Buffer | |
VoxelizeMesh | 每线程处理一个三角形并写入累积 Buffer | |
ResolveVoxelAccumulation | 解码累积值并写入浮点 3D GBuffer |
Resolve 时,没有表面样本的体素写入零 Albedo 与默认编码法线;有表面样本的体素解码平均 Albedo、Normal 和 Emissive,并写入持久的 AlbedoOpacity、Normal、Emissive 纹理。Opacity 保持占用和遮挡语义,而不是相机颜色的透明度。至此,Renderer、Raw Mesh Buffer、材质属性和三角形覆盖都被压缩为规则三维数据,后续光照阶段只需读取这些 GBuffer。